
Vos équipes utilisent déjà l'IA. La question n'est plus de savoir si elles vont s'y mettre, mais avec quel outil, et où partent vos données.
Ce guide, c'est la méthode qu'on applique chez Out of Office pour remplacer les comptes perso par une IA privée : Claude, utilisé depuis votre propre compte cloud, sans que vos données passent par Anthropic, ou un modèle ouvert installé sur vos serveurs. Et pour former les équipes à s'en servir. Il s'adresse au dirigeant, au DAF ou au DSI qui doit trancher. Tous les modèles de documents (questionnaire, charte, prompts par service) sont dans le fichier à télécharger plus haut.
L'idée qui résume tout : interdire l'IA ne protège pas vos données, ça les fait passer sur les téléphones. Ce qui les protège, c'est un outil aussi simple que ChatGPT, mais chez vous, et des équipes qui savent ce qu'on peut lui confier.
Étape 1 · Faites l'état des lieux, sans chercher de coupables (1 semaine)
Avant de choisir un outil, sachez ce qui se passe déjà. Envoyez un questionnaire anonyme à toute l'entreprise (modèle dans le fichier) :
- Utilisez-vous un outil d'IA dans votre travail ? Lequel, avec quel compte (perso ou pro) ?
- Pour quelles tâches ? Rédiger, résumer, traduire, analyser un tableau, chercher une info…
- Quels documents y avez-vous déjà collés ? Contrats, exports, comptes rendus, données clients…
- Combien de temps ça vous fait gagner par semaine, à peu près ?
Annoncez-le clairement : personne ne sera sanctionné. Le but est de comprendre les usages pour leur donner un meilleur outil. Si vous menacez, vous n'aurez aucune réponse honnête.
Ce que vous allez découvrir : les personnes les plus avancées sont souvent vos meilleurs éléments. Ce seront vos futurs référents (étape 9).
Étape 2 · Classez vos données en 3 niveaux (½ journée)
Une règle que tout le monde comprend vaut mieux qu'une politique de 40 pages.
| Niveau | Exemples | Où on peut l'utiliser |
|---|---|---|
| Public | Fiches produits, site internet, offres d'emploi | N'importe quel outil d'IA |
| Interne | Procédures, comptes rendus de réunion, plannings, documentation | Uniquement l'IA privée de l'entreprise |
| Confidentiel | Contrats, prix négociés, paie, données RH, comités de direction, données clients nominatives | Uniquement l'IA privée, avec accès limité aux personnes habilitées |
Faites valider ce tableau par la direction, le juridique et le DSI. Il servira à la fois à la charte (étape 9) et aux droits d'accès (étape 7).
Étape 3 · Choisissez où l'IA tourne (1 décision)
Trois options, de la plus simple à la plus fermée :
| Option | Comment | Pour | Contre |
|---|---|---|---|
| A. Claude dans votre cloud | Vous activez Claude dans votre propre compte AWS (Bedrock) ou Google Cloud (Vertex AI), dans une région européenne | Les meilleurs modèles du marché, rien à installer, paiement à l'usage, Anthropic ne reçoit ni vos demandes ni les réponses | Vos données restent chez votre fournisseur cloud, sous votre contrat, et ce fournisseur est américain |
| B. Modèle ouvert sur un serveur dédié en France | Un serveur avec carte graphique chez un hébergeur français, qui n'appartient qu'à vous | Données hors de toute plateforme d'IA et de tout acteur américain | Modèle un peu moins fort, abonnement mensuel, maintenance |
| C. Modèle ouvert sur vos propres serveurs | Le modèle tourne dans votre salle serveur ou votre datacenter | Contrôle total, rien ne sort du réseau | Achat du matériel, délais, compétences internes |
Comment l'option A protège vos données
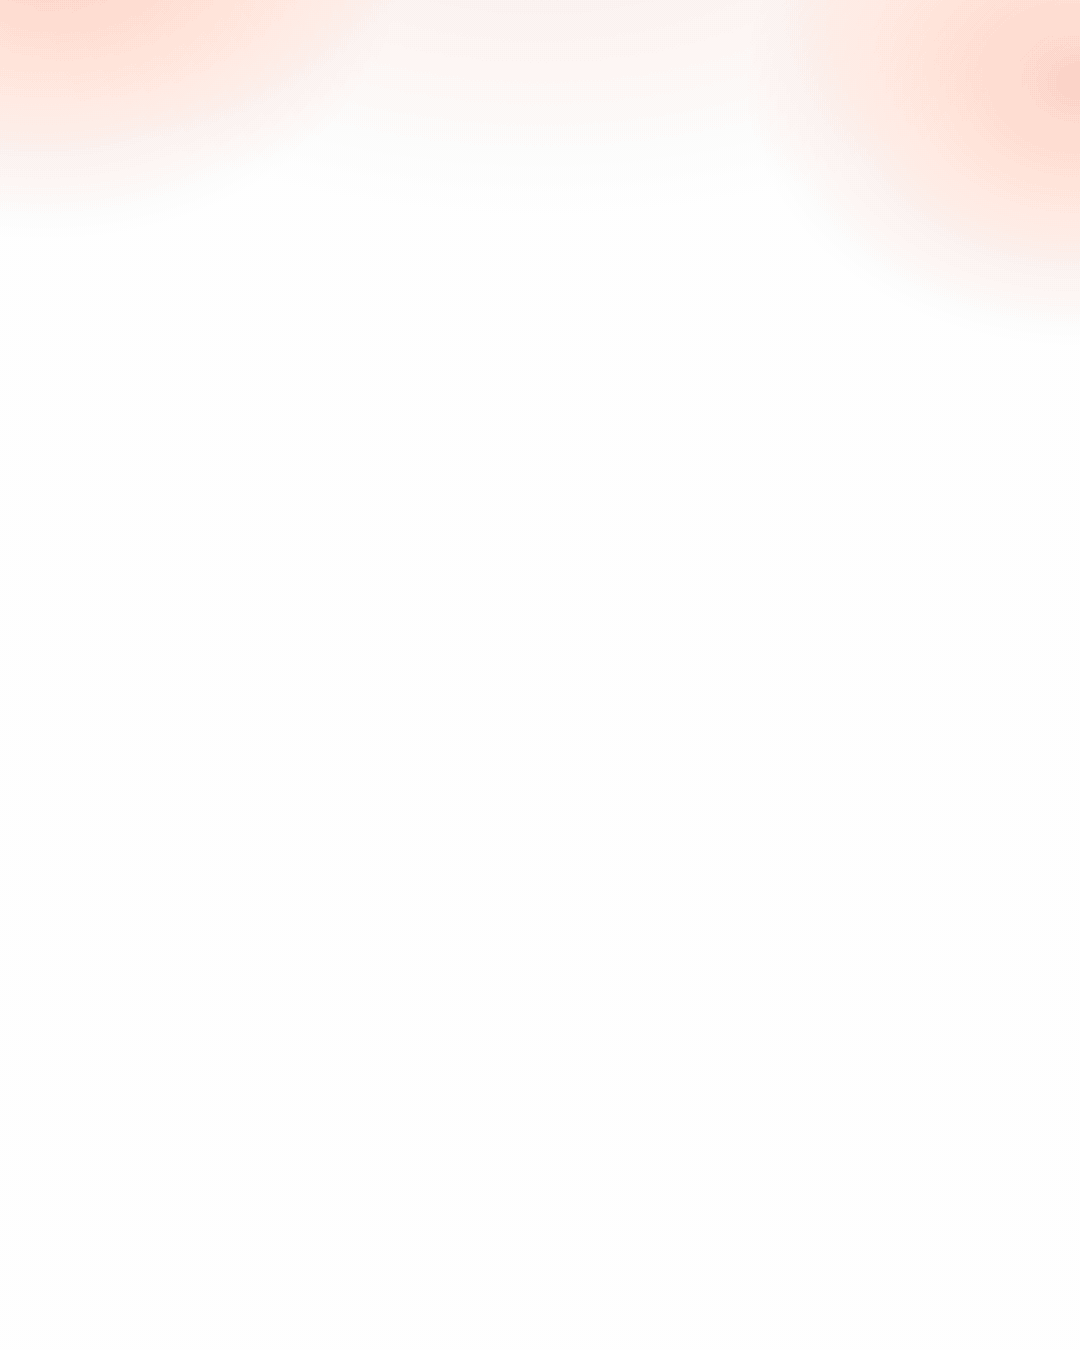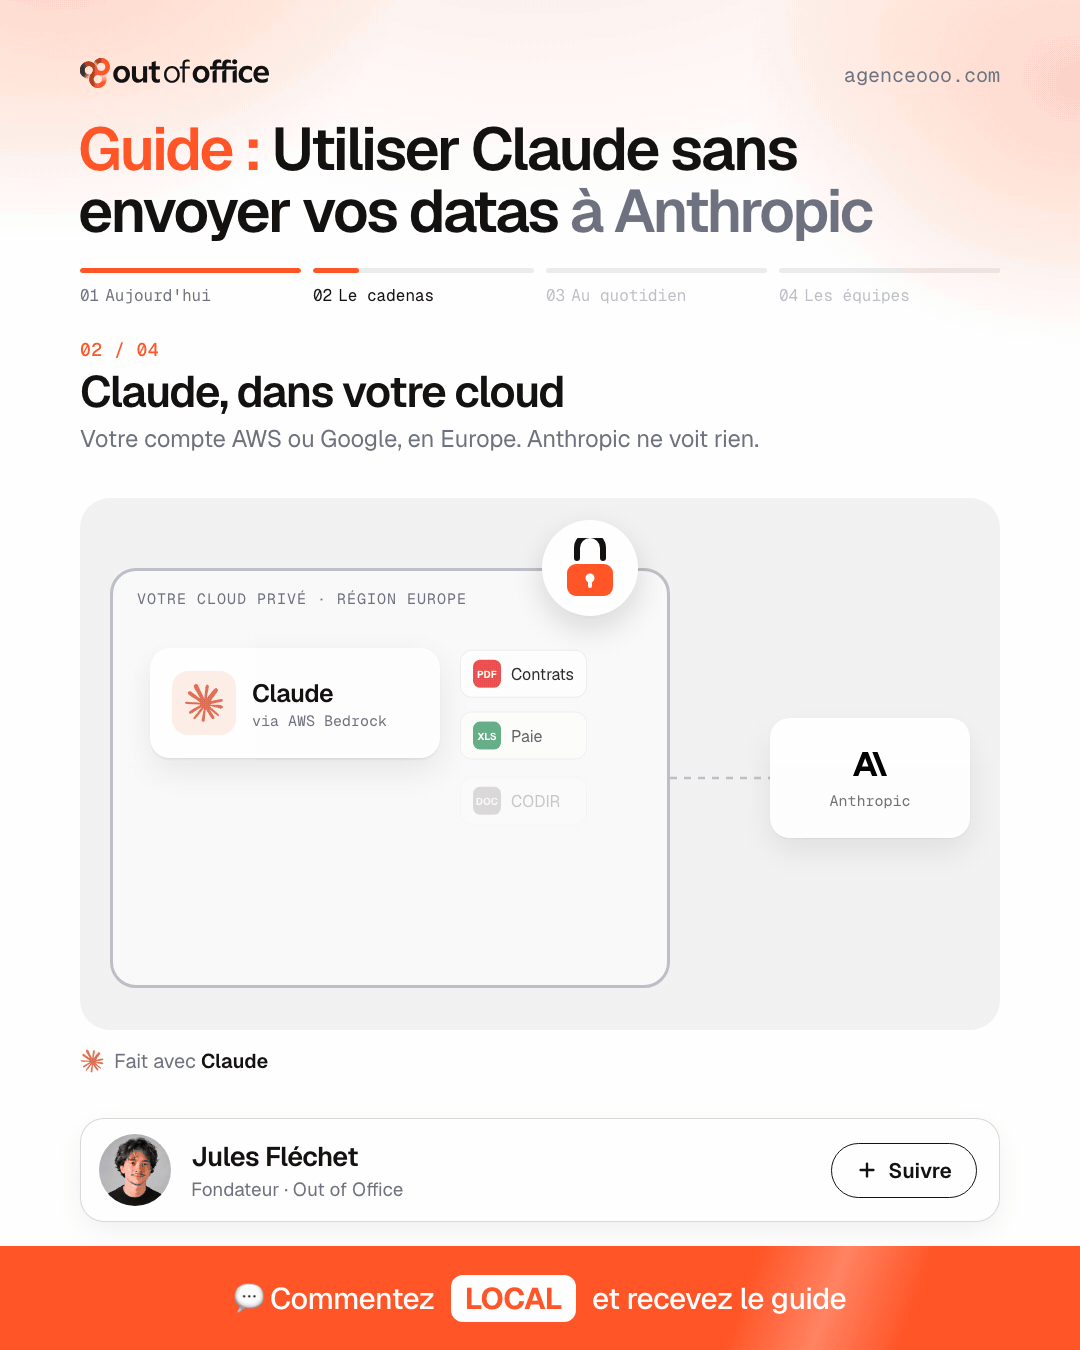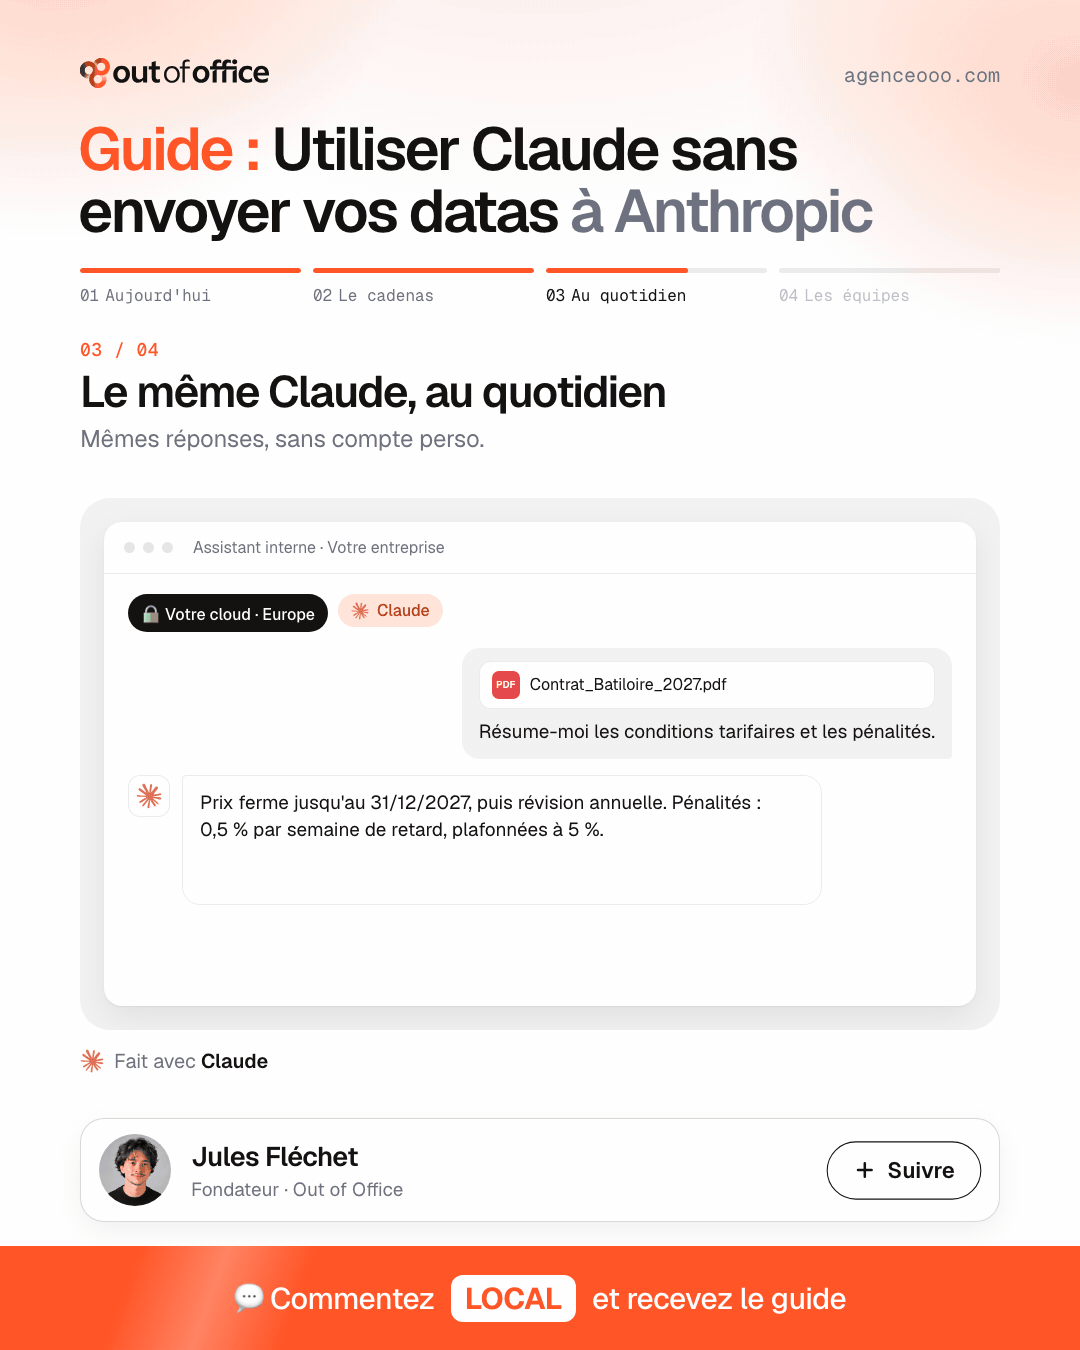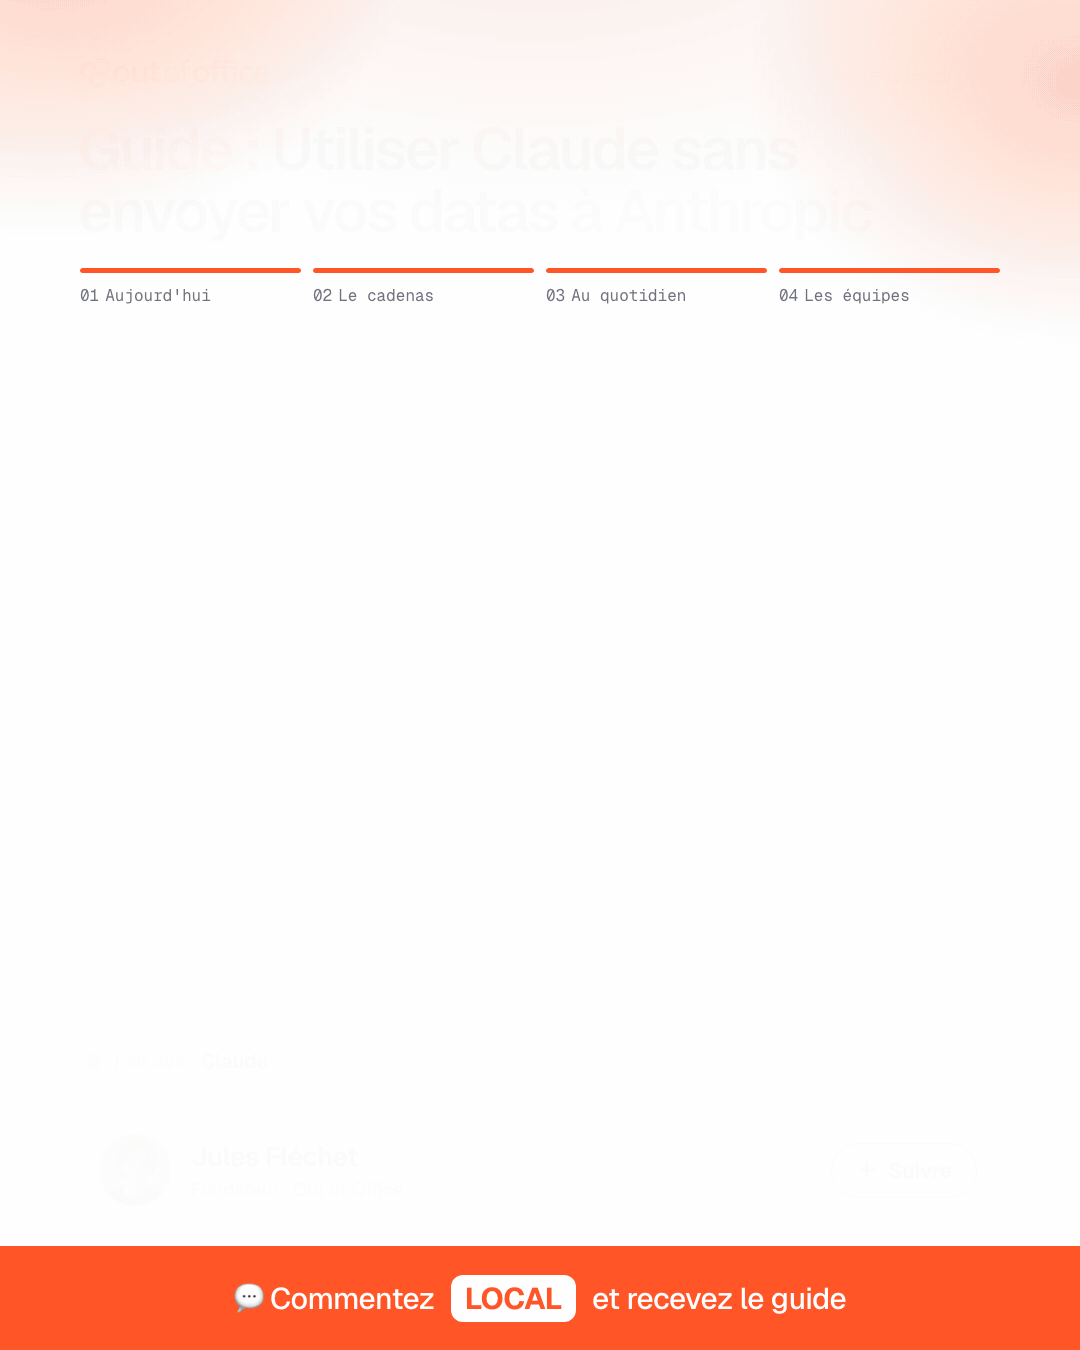
Quand vous passez par Bedrock ou Vertex AI, Claude tourne dans l'infrastructure d'AWS ou de Google, pas chez Anthropic. Concrètement :
- Anthropic n'a pas accès à vos demandes ni aux réponses.
- Vos données ne servent pas à entraîner les modèles.
- Vous choisissez une région européenne (Paris, Francfort, Irlande…) et un profil d'inférence européen, pour que les traitements restent en Europe.
- Les accès passent par vos comptes et vos règles (IAM), et les appels sont journalisés dans votre compte.
C'est le même Claude que celui de vos équipes, avec les mêmes réponses. La différence, c'est le chemin que prennent vos données.
A, B ou C ?
Pour la plupart des entreprises, l'option A est le bon point de départ : on démarre en quelques jours, avec le meilleur modèle, et sans matériel.
Un point à connaître : AWS et Google sont des sociétés américaines, soumises au droit américain (Cloud Act), même quand leurs serveurs sont en Europe. Si c'est un sujet pour vos clients ou votre secteur (défense, santé, données très sensibles), gardez ces données sur l'option B ou C. Les options se combinent : Claude dans votre cloud pour l'essentiel, un modèle ouvert chez vous pour le plus sensible.
Étape 4 · Choisissez le modèle (1 à 2 semaines de tests)
Option A. Claude existe en plusieurs tailles : Haiku (rapide et économique, pour les tâches simples et en volume), Sonnet (le bon choix par défaut pour la plupart des usages) et Opus (le plus puissant, pour les analyses longues et complexes). Commencez par Sonnet, et réservez les autres aux cas où ils font une différence.
Options B et C. Les modèles dits « ouverts » se téléchargent et tournent sur votre propre machine. Les familles les plus utilisées :
- Mistral (français) : bon en français, plusieurs tailles, licences permissives sur une partie des modèles.
- gpt-oss (OpenAI) : deux tailles, licence Apache 2.0.
- Qwen (Alibaba) et Llama (Meta) : très répandus, vérifiez la licence pour un usage commercial.
La taille du modèle décide du serveur :
| Taille du modèle | Pour quoi | Serveur qu'il faut |
|---|---|---|
| Petit (≈ 20 à 30 milliards de paramètres) | Résumer, rédiger, chercher dans les documents, répondre aux questions courantes | Une carte graphique de 48 Go (ex. L40S) |
| Grand (≈ 70 à 120 milliards de paramètres) | Raisonnements plus longs, analyses complexes, documents techniques | Une carte de 80 Go (ex. H100), ou deux cartes |
Ne choisissez pas sur un classement trouvé en ligne. Prenez 20 vraies demandes de vos équipes (récupérées à l'étape 1), faites-les passer à 2 ou 3 modèles, et faites noter les réponses par les personnes concernées. C'est la seule évaluation qui compte.
Soyez honnête avec la direction : un modèle qui tourne chez vous est un peu moins fort que les meilleurs modèles du marché. Pour résumer, rédiger ou chercher dans vos documents, l'écart se voit très peu. Pour les usages où il compte, on peut combiner : l'IA privée pour tout ce qui est interne ou confidentiel, un modèle du marché pour les données publiques.
Étape 5 · Faites le calcul (½ journée)
Ordres de grandeur constatés chez les hébergeurs français fin 2026, à vérifier au moment du devis :
| Poste | Ordre de grandeur |
|---|---|
| Claude dans votre cloud (option A) | pas d'abonnement : vous payez au volume de texte traité, selon le modèle choisi. Un pilote d'un mois sur un service donne le vrai chiffre |
| Serveur dédié avec une carte 48 Go (option B) | autour de 1 000 € par mois |
| Serveur dédié avec une carte 80 Go (option B) | de 2 000 à 3 000 € par mois |
| Achat d'un serveur équipé (option C) | plusieurs dizaines de milliers d'euros, plus l'hébergement |
| Mise en place (installation, documents, sécurité) | quelques jours à quelques semaines de travail |
| Formation des équipes | un atelier de 2 h par service, plus les référents |
À comparer avec les licences d'un assistant IA en version entreprise, de l'ordre de 20 à 40 € par utilisateur et par mois. Avec l'option A, vous payez ce que vos équipes utilisent vraiment. Avec les options B et C, un serveur dédié coûte le même prix que vous ayez 50 ou 500 utilisateurs : plus l'entreprise est grande, plus il devient intéressant.
N'oubliez pas la ligne qui ne figure sur aucun devis : ce que coûterait une fuite d'un contrat, d'une grille de prix ou d'un fichier de paie.
Étape 6 · Installez (1 à 3 jours)
Option A : Claude dans votre cloud
- Dans votre compte AWS, ouvrez Amazon Bedrock dans une région européenne et demandez l'accès aux modèles Claude (dans Google Cloud : Vertex AI, Model Garden).
- Utilisez un profil d'inférence européen, pour que les demandes restent traitées en Europe.
- Créez un rôle d'accès dédié, limité à l'appel des modèles Claude.
- Installez une interface de chat pour les équipes, hébergée dans votre cloud. LibreChat se branche directement sur Bedrock ; Open WebUI aussi, via une passerelle. Les équipes y retrouvent une expérience proche de ChatGPT ou de Claude.ai.
- Pour vos équipes techniques, Claude Code peut lui aussi passer par Bedrock ou Vertex AI : le code et les fichiers qu'il lit ne transitent alors pas par Anthropic.
Options B et C : modèle ouvert
- Le moteur, qui fait tourner le modèle. En production, on utilise en général vLLM, qui gère plusieurs utilisateurs en même temps. Pour un premier test sur un poste, Ollama est plus simple.
- L'interface : Open WebUI gère les comptes, les groupes, les documents et l'historique.
Dans les deux cas, votre DSI ou votre prestataire peut faire l'installation, ou la faire préparer avec Claude Code (configuré sur Bedrock ou Vertex AI). Les prompts complets sont dans le fichier à télécharger.
Étape 7 · Branchez vos documents (1 à 2 semaines)
Un assistant qui ne connaît pas l'entreprise reste un gadget. Branchez-le sur vos documents, mais commencez petit :
- 2 ou 3 dossiers à forte valeur et peu sensibles pour démarrer : procédures, documentation produit, modèles de documents.
- Puis les dossiers confidentiels, en reproduisant les droits d'accès existants : si une personne n'a pas accès au dossier Paie dans votre partage de fichiers, elle ne doit pas y avoir accès dans l'assistant.
- Prévoyez la mise à jour : un document modifié doit être réindexé, sinon l'assistant répondra avec l'ancienne version.
Demandez toujours à l'assistant de citer sa source (document et page). Les équipes vérifient, et la confiance vient vite.
Étape 8 · Sécurisez (en même temps que l'étape 6)
La liste à valider avec votre DSI avant d'ouvrir l'outil :
- Connexion avec les comptes de l'entreprise (Microsoft Entra ID, Google Workspace…). Pas de comptes créés à la main, et un départ de l'entreprise coupe l'accès automatiquement.
- Pas d'accès public : l'assistant n'est joignable que depuis le réseau de l'entreprise ou par VPN, en HTTPS.
- Journal des accès : qui a utilisé quoi, quand, et les accès refusés.
- Durée de conservation des conversations décidée et appliquée (par exemple 90 jours).
- Sauvegardes de la configuration et des index de documents.
- Mises à jour du moteur et de l'interface, à planifier tous les mois.
- Le modèle n'a pas accès à internet, sauf décision explicite.
- Option A : vérifiez que la région européenne et le profil d'inférence européen sont bien ceux utilisés, et que les journaux d'appels restent dans votre compte.
Étape 9 · Formez les équipes (2 à 4 semaines)
C'est l'étape qu'on saute le plus souvent, et c'est celle qui décide si l'outil sera utilisé.
- Une charte d'une page (modèle dans le fichier) : le tableau de l'étape 2, les usages encouragés, les usages interdits, à qui poser ses questions. Faites-la signer, ou au minimum lire et valider.
- Un atelier de 2 h par service, avec leurs vrais documents et leurs vraies tâches. La compta ne travaille pas comme les achats : un atelier général ne marche pas.
- Des référents IA : les personnes repérées à l'étape 1. Elles répondent aux questions de leur service et font remonter les besoins.
- Une bibliothèque de prompts par service, dans l'outil, que chacun peut enrichir (exemples dans le fichier).
- Les comptes perso : une fois l'outil interne disponible, demandez clairement de basculer. Ne sanctionnez pas ce qui s'est fait avant : les gens ont pris l'initiative quand il n'y avait rien d'autre.
Étape 10 · Mesurez et élargissez (chaque mois)
Suivez quatre indicateurs simples :
- le nombre de personnes qui l'utilisent chaque semaine ;
- les usages les plus fréquents, par service ;
- les accès refusés (ils montrent où les droits sont mal réglés, ou où un besoin n'est pas couvert) ;
- les retours des référents.
Puis élargissez : nouveaux dossiers, nouveaux services, premières tâches automatisées. L'IA devient vraiment utile quand elle a accès à toutes vos données au même endroit : vos clients, vos commandes, vos factures. C'est le sujet de l'étape suivante, l'ERP IA.
Les pièges qui font échouer un projet d'IA privée
- Interdire avant de proposer. Les usages passent sur les téléphones et vous perdez toute visibilité.
- Choisir le plus gros modèle « au cas où ». Opus pour tout, ou un serveur deux fois plus gros : la facture grimpe pour un écart que vos équipes ne verront pas sur la plupart des tâches.
- Croire qu'un compte « entreprise » sur un site grand public suffit. Vérifiez où passent les données, et qui y a accès, contrat en main.
- Brancher tous les documents d'un coup. Les droits d'accès sont mal réglés et un fichier de paie se retrouve dans les réponses.
- Oublier la formation. L'outil est installé, personne ne s'en sert, et les comptes perso reviennent.
- Laisser le projet au seul service informatique. Il faut un sponsor à la direction et des référents dans les métiers.
La checklist
- Questionnaire anonyme envoyé et analysé
- Données classées en 3 niveaux, validées par la direction
- Option d'hébergement choisie (A, B ou C, ou une combinaison)
- Claude activé dans votre cloud, en région européenne (option A)
- Modèle testé sur 20 vraies demandes
- Budget validé
- Interface installée pour les équipes
- Connexion par les comptes de l'entreprise, pas d'accès public
- Journal des accès et durée de conservation en place
- Premiers dossiers branchés, avec les bons droits
- Charte signée
- Un atelier par service, des référents nommés
- Indicateurs suivis chaque mois


